Configuración, Exportación y Visualización de Resultados
Source:vignettes/visualizacion_y_exportacion.Rmd
visualizacion_y_exportacion.RmdIntroducción
El paquete peruocc está diseñado tanto para la
exploración interactiva y rápida de ocurrencias de biodiversidad en
memoria, como para flujos de trabajo reproducibles en producción y
análisis espacial (SIG).
Esta guía explica: 1. Cómo configurar el directorio de almacenamiento
y caché (peruocc_data_dir()). 2. La diferencia entre
consultas interactivas en memoria
(guardar_resultados = FALSE) y persistencia en disco
(guardar_resultados = TRUE). 3. La función dedicada
exportar_resultados() y los formatos generados (CSV,
GeoJSON y Manifiesto de reproducibilidad). 4. La visualización
cartográfica con graficar_ocurrencias().
1. Configuración del Directorio de Trabajo:
peruocc_data_dir()
La función peruocc_data_dir() permite centralizar
opcionalmente la ubicación en el disco donde se almacenarán capas
espaciales descargadas en caché y los resultados exportados.
library(peruocc)
#> ── Cargando peruocc ────────────────────────────────────────────────── v0.1.0 ──
#> ✔ geoperu 0.0.1   • Límites cartográficos oficiales del Perú
#> ✔ rgbif   3.8.5   • Extracción de ocurrencias desde GBIF
#> ✔ rinat   0.1.10  • Observaciones ciudadanas de iNaturalist
#> ✔ sf      1.1.2   • Operaciones geométricas y filtros espaciales
# Configurar el directorio raíz del proyecto para artefactos (opcional)
peruocc_data_dir("mi-carpeta-proyecto")
¿Por qué es útil y cómo funciona?
- Control y Orden del Proyecto: Mantiene todas las salidas y capas auxiliares organizadas en una única carpeta personalizada en lugar de dispersarlas en la raíz de trabajo.
-
Caché Opcional de Geometrías: Al configurar una
ruta, el paquete guarda copias
.rdsencache/. Las siguientes consultas a esa misma zona cargarán la geometría instantáneamente sin volver a descargarla de internet. -
Configuración Global Transparente: Al ejecutar
peruocc_data_dir(), la ruta se guarda en las opciones de R (options(peruocc.data_dir = ...)).
¿Qué ocurre si NO ejecuto peruocc_data_dir()?
No habrá ningún error y las consultas funcionarán con
normalidad. * Caché: peruocc
almacena las capas en la memoria RAM de la sesión
(.peruocc_mem_cache), garantizando cero escrituras en disco
no solicitadas. * Exportaciones: Si decides exportar
archivos más adelante con exportar_resultados(),
simplemente indica la carpeta deseada mediante el argumento
dir_salida (por ejemplo,
dir_salida = tempdir()).
2. Ejecución en Memoria vs. Guardado en Disco
(guardar_resultados)
Todas las funciones principales de búsqueda
(buscar_especies_distrito(),
buscar_especies_provincia(),
buscar_especies_peru()) incluyen el argumento
guardar_resultados.
# Firma de la función
buscar_especies_distrito(
  distrito,
  departamento = NULL,
  provincia = NULL,
  ...,
  guardar_resultados = FALSE  # <- FALSE por defecto
)
Comparativa: Consultas Experimentales vs. Guardado Automático
| Característica |
guardar_resultados = FALSE (Por defecto /
Experimental) |
guardar_resultados = TRUE (Guardado
Automático) |
|---|---|---|
| Destino de datos | Solo memoria RAM en la sesión de R. | Memoria RAM + archivos guardados en disco. |
| Velocidad de ejecución | Más rápida. Evita la sobrecarga de I/O y serialización espacial. | Requiere tiempo adicional para escribir CSV, GeoJSON y JSON. |
| Archivos generados | Ninguno. |
.csv, .geojson y
manifiesto_*.json en la subcarpeta
processed/. |
| Casos de uso | Análisis exploratorio, filtrado rápido, visualización interactiva y pruebas de parámetros. | Pipelines automatizados, ejecuciones desatendidas o procesamiento en lotes (batch). |
Flujo de Trabajo Recomendado
Para la mayoría de los análisis, la mejor práctica es trabajar primero en memoria y luego exportar selectivamente cuando los datos estén listos:
# Paso 1: Consulta rápida en memoria (experimental / interactiva)
resultado <- buscar_especies_distrito(
  distrito = "Miraflores",
  departamento = "Lima",
  provincia = "Lima",
  grupo = "flora",
  limite_por_api = 150
)
#>
#> ── Búsqueda Integrada: MIRAFLORES (DISTRITO) ───────────────────────────────────
#> • Departamento: Lima
#> • Provincia: Lima
#> • Grupo: flora
#> ℹ Descargando límites de LIMA vía geoperu...
#> ℹ [GBIF] Iniciando búsqueda de ocurrencias...
#> ✔ Polígono simplificado con éxito a tolerancia de 100 metros (WKT: 822 caracteres).
#> ℹ [GBIF] Filtrando por reino Plantae (Flora).
#> ℹ [GBIF] Consultando registros dentro del polígono de MIRAFLORES (límite: "150")...
#> ✔ [GBIF] Búsqueda finalizada. Se filtraron 148 registro(s) que caen dentro del polígono seleccionado.
#> ℹ [iNaturalist] Iniciando búsqueda de ocurrencias...
#> ℹ [iNaturalist] Filtrando por reino Plantae (Flora).
#> ℹ [iNaturalist] Consultando registros dentro de la caja delimitadora de MIRAFLORES (límite: "150")...
#> ℹ [iNaturalist] Se descargaron 150 registros en la caja delimitadora. Aplicando filtro espacial...
#> ✔ [iNaturalist] Búsqueda finalizada. 133 de 150 registros caen dentro del polígono seleccionado.
#> ✔ Consolidación exitosa. Total de registros unificados: 281
#>
#> ── Resumen de Registros ──
#>
#> • GBIF: 148 registro(s)
#> • iNaturalist: 133 registro(s)
#> ✔ Total consolidado: 281 registro(s)

# Paso 2: Inspeccionar resultados o graficar
summary(resultado$ocurrencias)
#>     occurrenceID   sourceRecordID     sourceURL       datasetKey
#>  Length   :281   Length   :281    Length   :281   Length   :281
#>  N.unique :281   N.unique :281    N.unique :281   N.unique :  2
#>  N.blank  :  0   N.blank  :  0    N.blank  :  0   N.blank  :  0
#>  Min.nchar: 10   Min.nchar:  9    Min.nchar: 42   Min.nchar: 36
#>  Max.nchar: 50   Max.nchar: 10    Max.nchar: 50   Max.nchar: 36
#>                                                   NAs      :133
#>
#>       license      basisOfRecord   scientificName decimalLatitude
#>  Length   :281   Length   :281   Length   :281    Min.   :-12.14
#>  N.unique :  8   N.unique :  2   N.unique :119    1st Qu.:-12.13
#>  N.blank  : 19   N.blank  :  0   N.blank  :  0    Median :-12.12
#>  Min.nchar:  0   Min.nchar: 16   Min.nchar: 11    Mean   :-12.12
#>  Max.nchar: 58   Max.nchar: 17   Max.nchar: 58    3rd Qu.:-12.12
#>                                                   Max.   :-12.11
#>
#>  decimalLongitude     eventDate       taxonRank        kingdom
#>  Min.   :-77.05   Length   :281   Length   :281   Length   :281
#>  1st Qu.:-77.04   N.unique :233   N.unique :  1   N.unique :  1
#>  Median :-77.03   N.blank  :  0   N.blank  :  0   N.blank  :  0
#>  Mean   :-77.03   Min.nchar: 10   Min.nchar:  7   Min.nchar:  7
#>  3rd Qu.:-77.03   Max.nchar: 20   Max.nchar:  7   Max.nchar:  7
#>  Max.   :-77.01                   NAs      :133
#>
#>        phylum          class           order           family
#>  Length   :281   Length   :281   Length   :281   Length   :281
#>  N.unique :  2   N.unique :  4   N.unique : 21   N.unique : 35
#>  N.blank  :  0   N.blank  :  0   N.blank  :  0   N.blank  :  0
#>  Min.nchar: 10   Min.nchar:  9   Min.nchar:  6   Min.nchar:  7
#>  Max.nchar: 12   Max.nchar: 15   Max.nchar: 14   Max.nchar: 16
#>  NAs      :133   NAs      :133   NAs      :133   NAs      :133
#>
#>        genus          species        recordedBy  coordinateUncertaintyInMeters
#>  Length   :281   Length   :281   Length   :281   Min.   :   2.0
#>  N.unique : 53   N.unique : 63   N.unique :119   1st Qu.:  12.0
#>  N.blank  :  0   N.blank  :  0   N.blank  :  0   Median :  21.0
#>  Min.nchar:  5   Min.nchar: 11   Min.nchar:  5   Mean   : 334.2
#>  Max.nchar: 16   Max.nchar: 28   Max.nchar: 30   3rd Qu.:  30.0
#>  NAs      :133   NAs      :133   NAs      : 10   Max.   :3945.0
#>                                                  NAs    :54
#>        source         district        province       department
#>  Length   :281   Length   :281   Length   :281   Length   :281
#>  N.unique :  2   N.unique :  1   N.unique :  1   N.unique :  1
#>  N.blank  :  0   N.blank  :  0   N.blank  :  0   N.blank  :  0
#>  Min.nchar:  4   Min.nchar: 10   Min.nchar:  4   Min.nchar:  4
#>  Max.nchar: 11   Max.nchar: 10   Max.nchar:  4   Max.nchar:  4
#>
#>

# Paso 3: Si los datos son conformes, exportar a disco
# exportar_resultados(resultado)
3. Exportación de Resultados y Estructura de Artefactos
La función exportar_resultados() toma el objeto devuelto
por cualquier búsqueda y genera artefactos estructurados y listos para
interoperabilidad:
# Exportación completa (por defecto a processed/ de peruocc_data_dir)
archivos <- exportar_resultados(resultado)

# Exportación personalizada a otra carpeta y formatos específicos:
exportar_resultados(
  resultado = resultado,
  dir_salida = "mis_analisis/capas",
  formatos = c("csv", "geojson")
)
Estructura del Directorio de Salida
Cuando se utiliza peruocc_data_dir("peruocc-output"), la
estructura queda organizada de la siguiente manera:
peruocc-output/
├── cache/
│   ├── distritos_lima.rds                 # Geometrías oficiales cacheadas
│   └── distritos_peru_completo.rds
└── processed/
    ├── ocurrencias_distrito_miraflores_flora.csv
    ├── ocurrencias_distrito_miraflores_flora.geojson
    └── manifiesto_distrito_miraflores_flora.json
Descripción de los Formatos Exportados
-
ocurrencias_*.csv:- Tabla plana estandarizada según el estándar internacional
Darwin Core (
scientificName,decimalLatitude,decimalLongitude,eventDate,source, etc.).
- Tabla plana estandarizada según el estándar internacional
Darwin Core (
-
ocurrencias_*.geojson:- Capa espacial vectorial de puntos con proyección geográfica WGS84 (EPSG:4326). Se puede arrastrar directamente a QGIS, ArcGIS o visores web (Leaflet, Mapbox).
-
manifiesto_*.json:- Manifiesto de auditoría y reproducibilidad científica. Registra:
- Fecha y hora exacta de la consulta (UTC).
- Versiones de R y paquetes utilizados (
sf,rgbif,rinat,geoperu). - Polígono de consulta en formato WKT (Well-Known Text).
- Parámetros y filtros aplicados (fechas, límites por API, reinos).
- Manifiesto de auditoría y reproducibilidad científica. Registra:
-
results/mapa_*.png(opcional):- Gráficos cartográficos en alta resolución (300 DPI) generados por
graficar_ocurrencias(..., guardar_mapa = TRUE).
- Gráficos cartográficos en alta resolución (300 DPI) generados por
4. Visualización Cartográfica con
graficar_ocurrencias()
La función graficar_ocurrencias() produce composiciones
visuales basadas en ggplot2, integrando la delimitación
poligonal oficial de fondo con las observaciones superpuestas.
Comparación por Proveedor de Datos (source)
# Visualizar diferenciando aportes de GBIF vs iNaturalist
mapa_fuente <- graficar_ocurrencias(
  resultado_lista = resultado,
  color_por = "source"
)

print(mapa_fuente)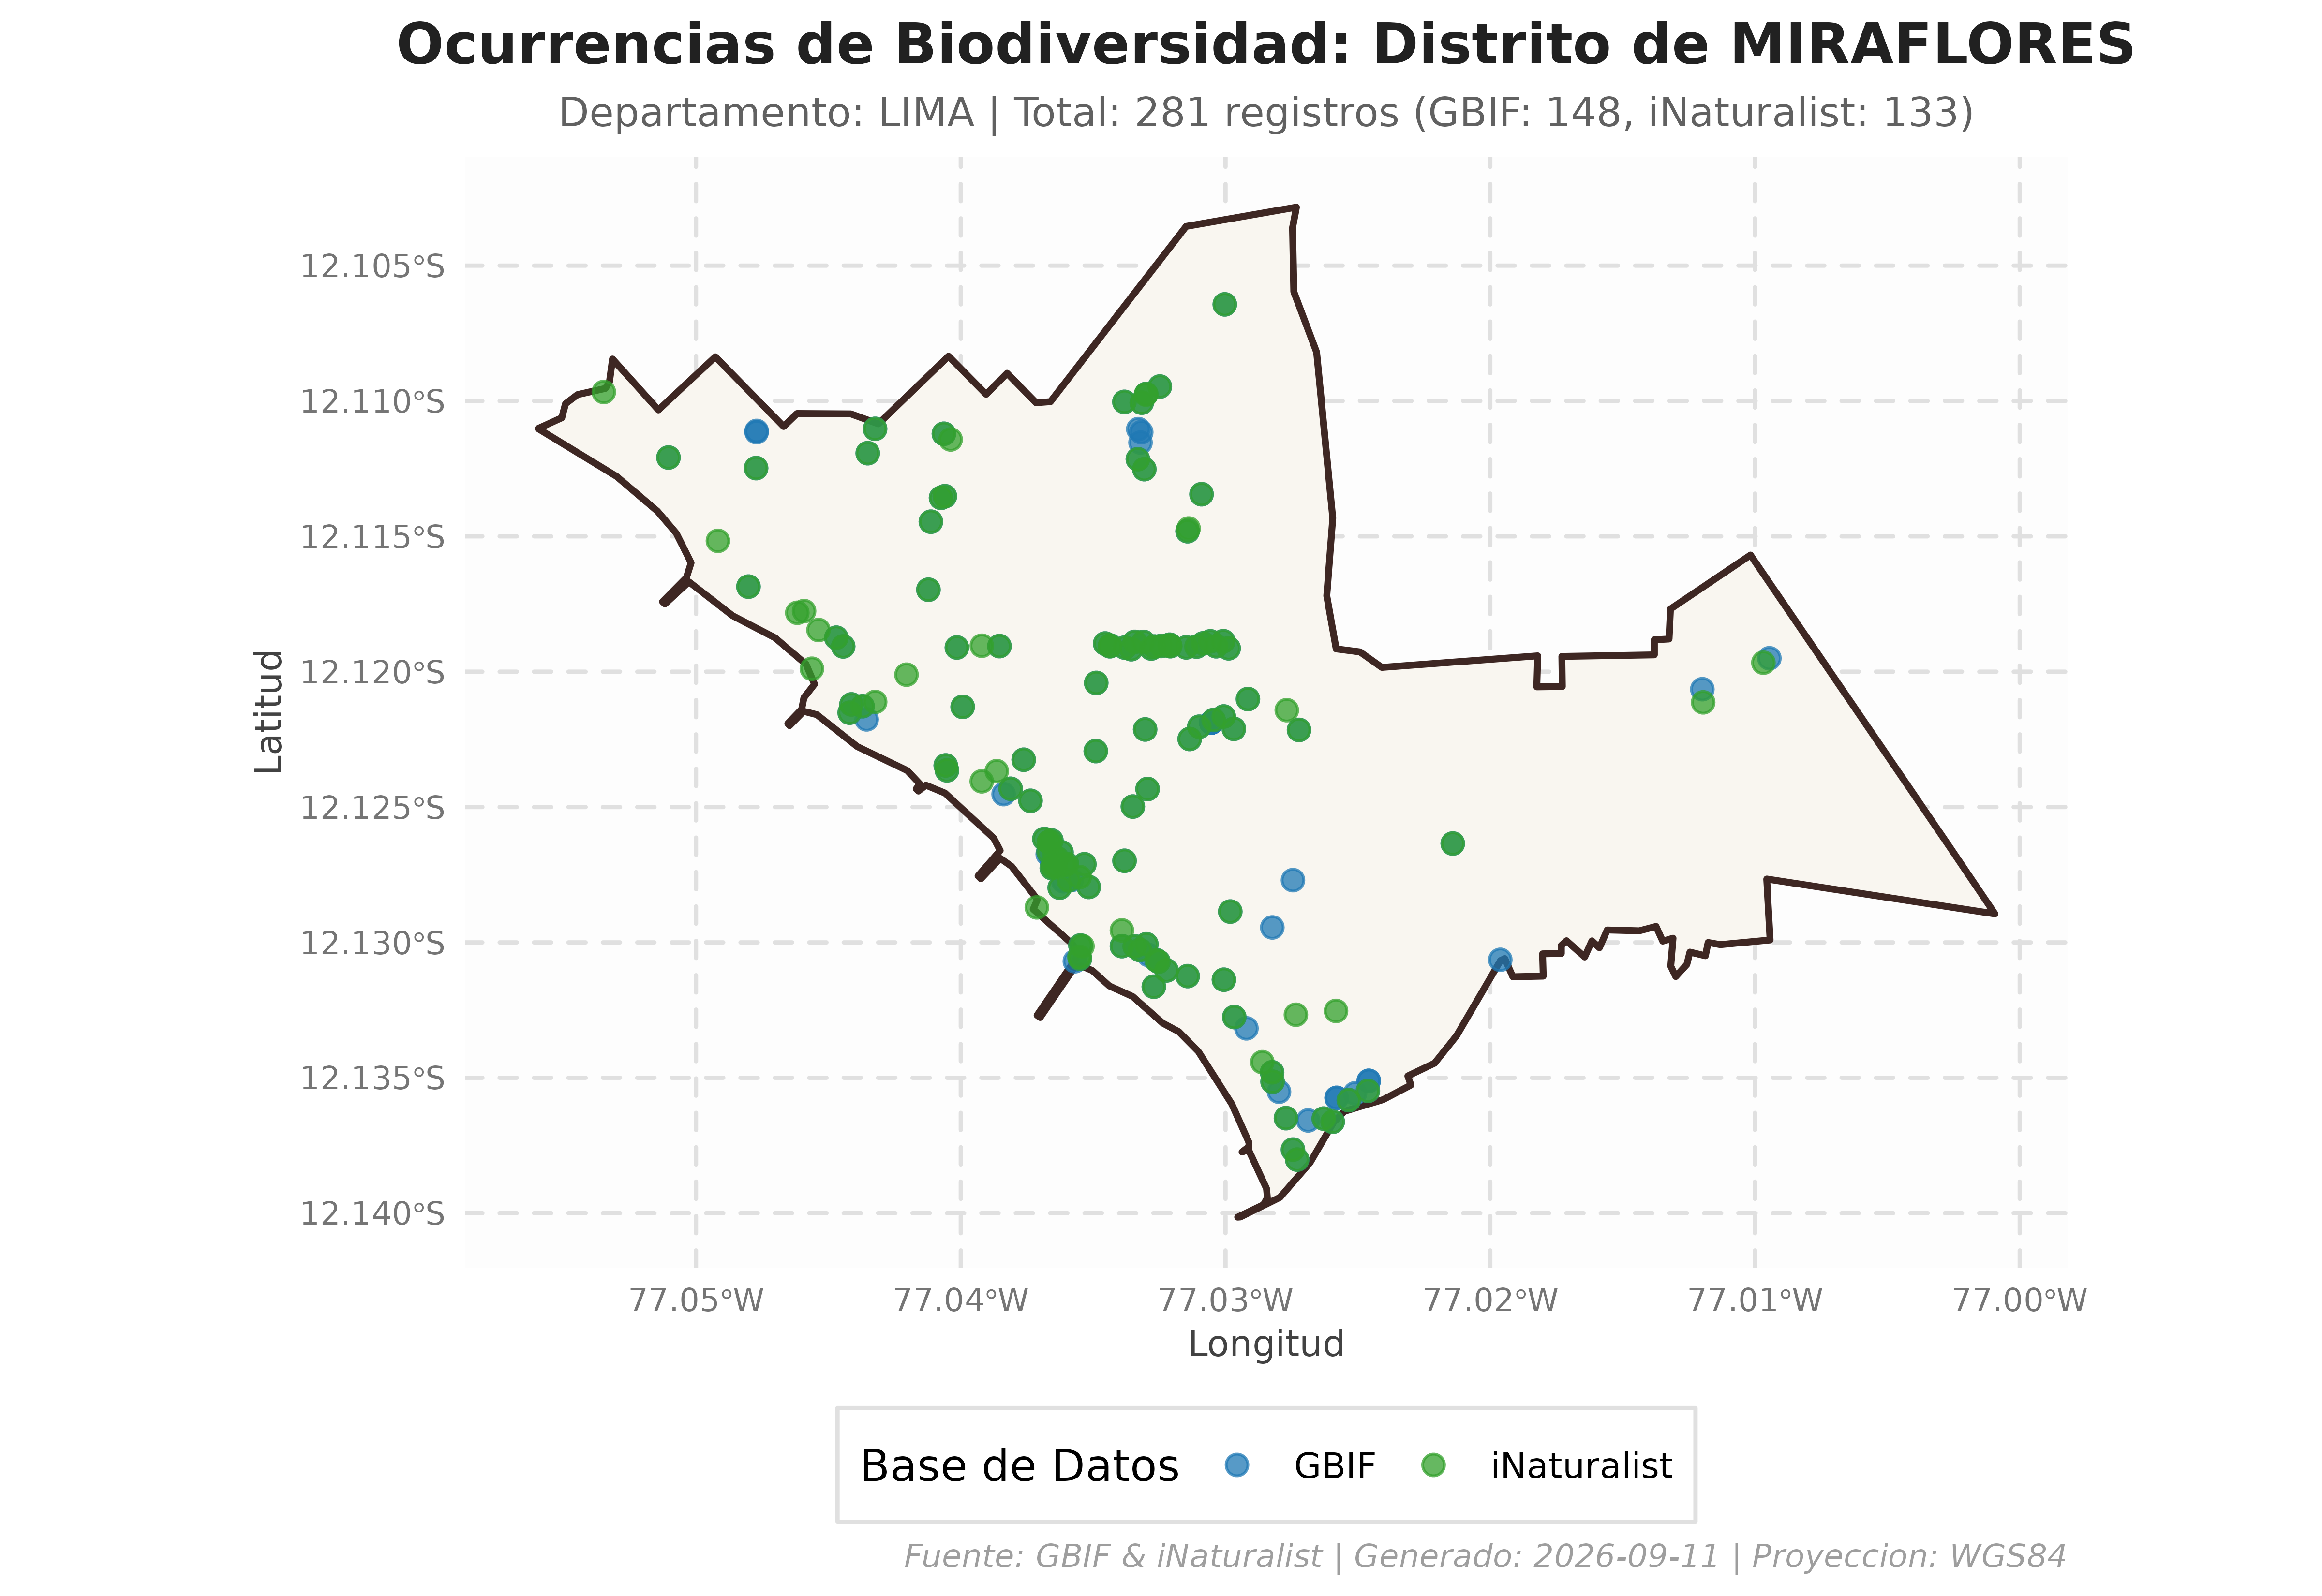
Comparación por Reino Biológico (kingdom)
# Visualizar distribución por reinos (Plantae, Animalia, Fungi, etc.)
mapa_reino <- graficar_ocurrencias(
  resultado_lista = resultado,
  color_por = "kingdom"
)

print(mapa_reino)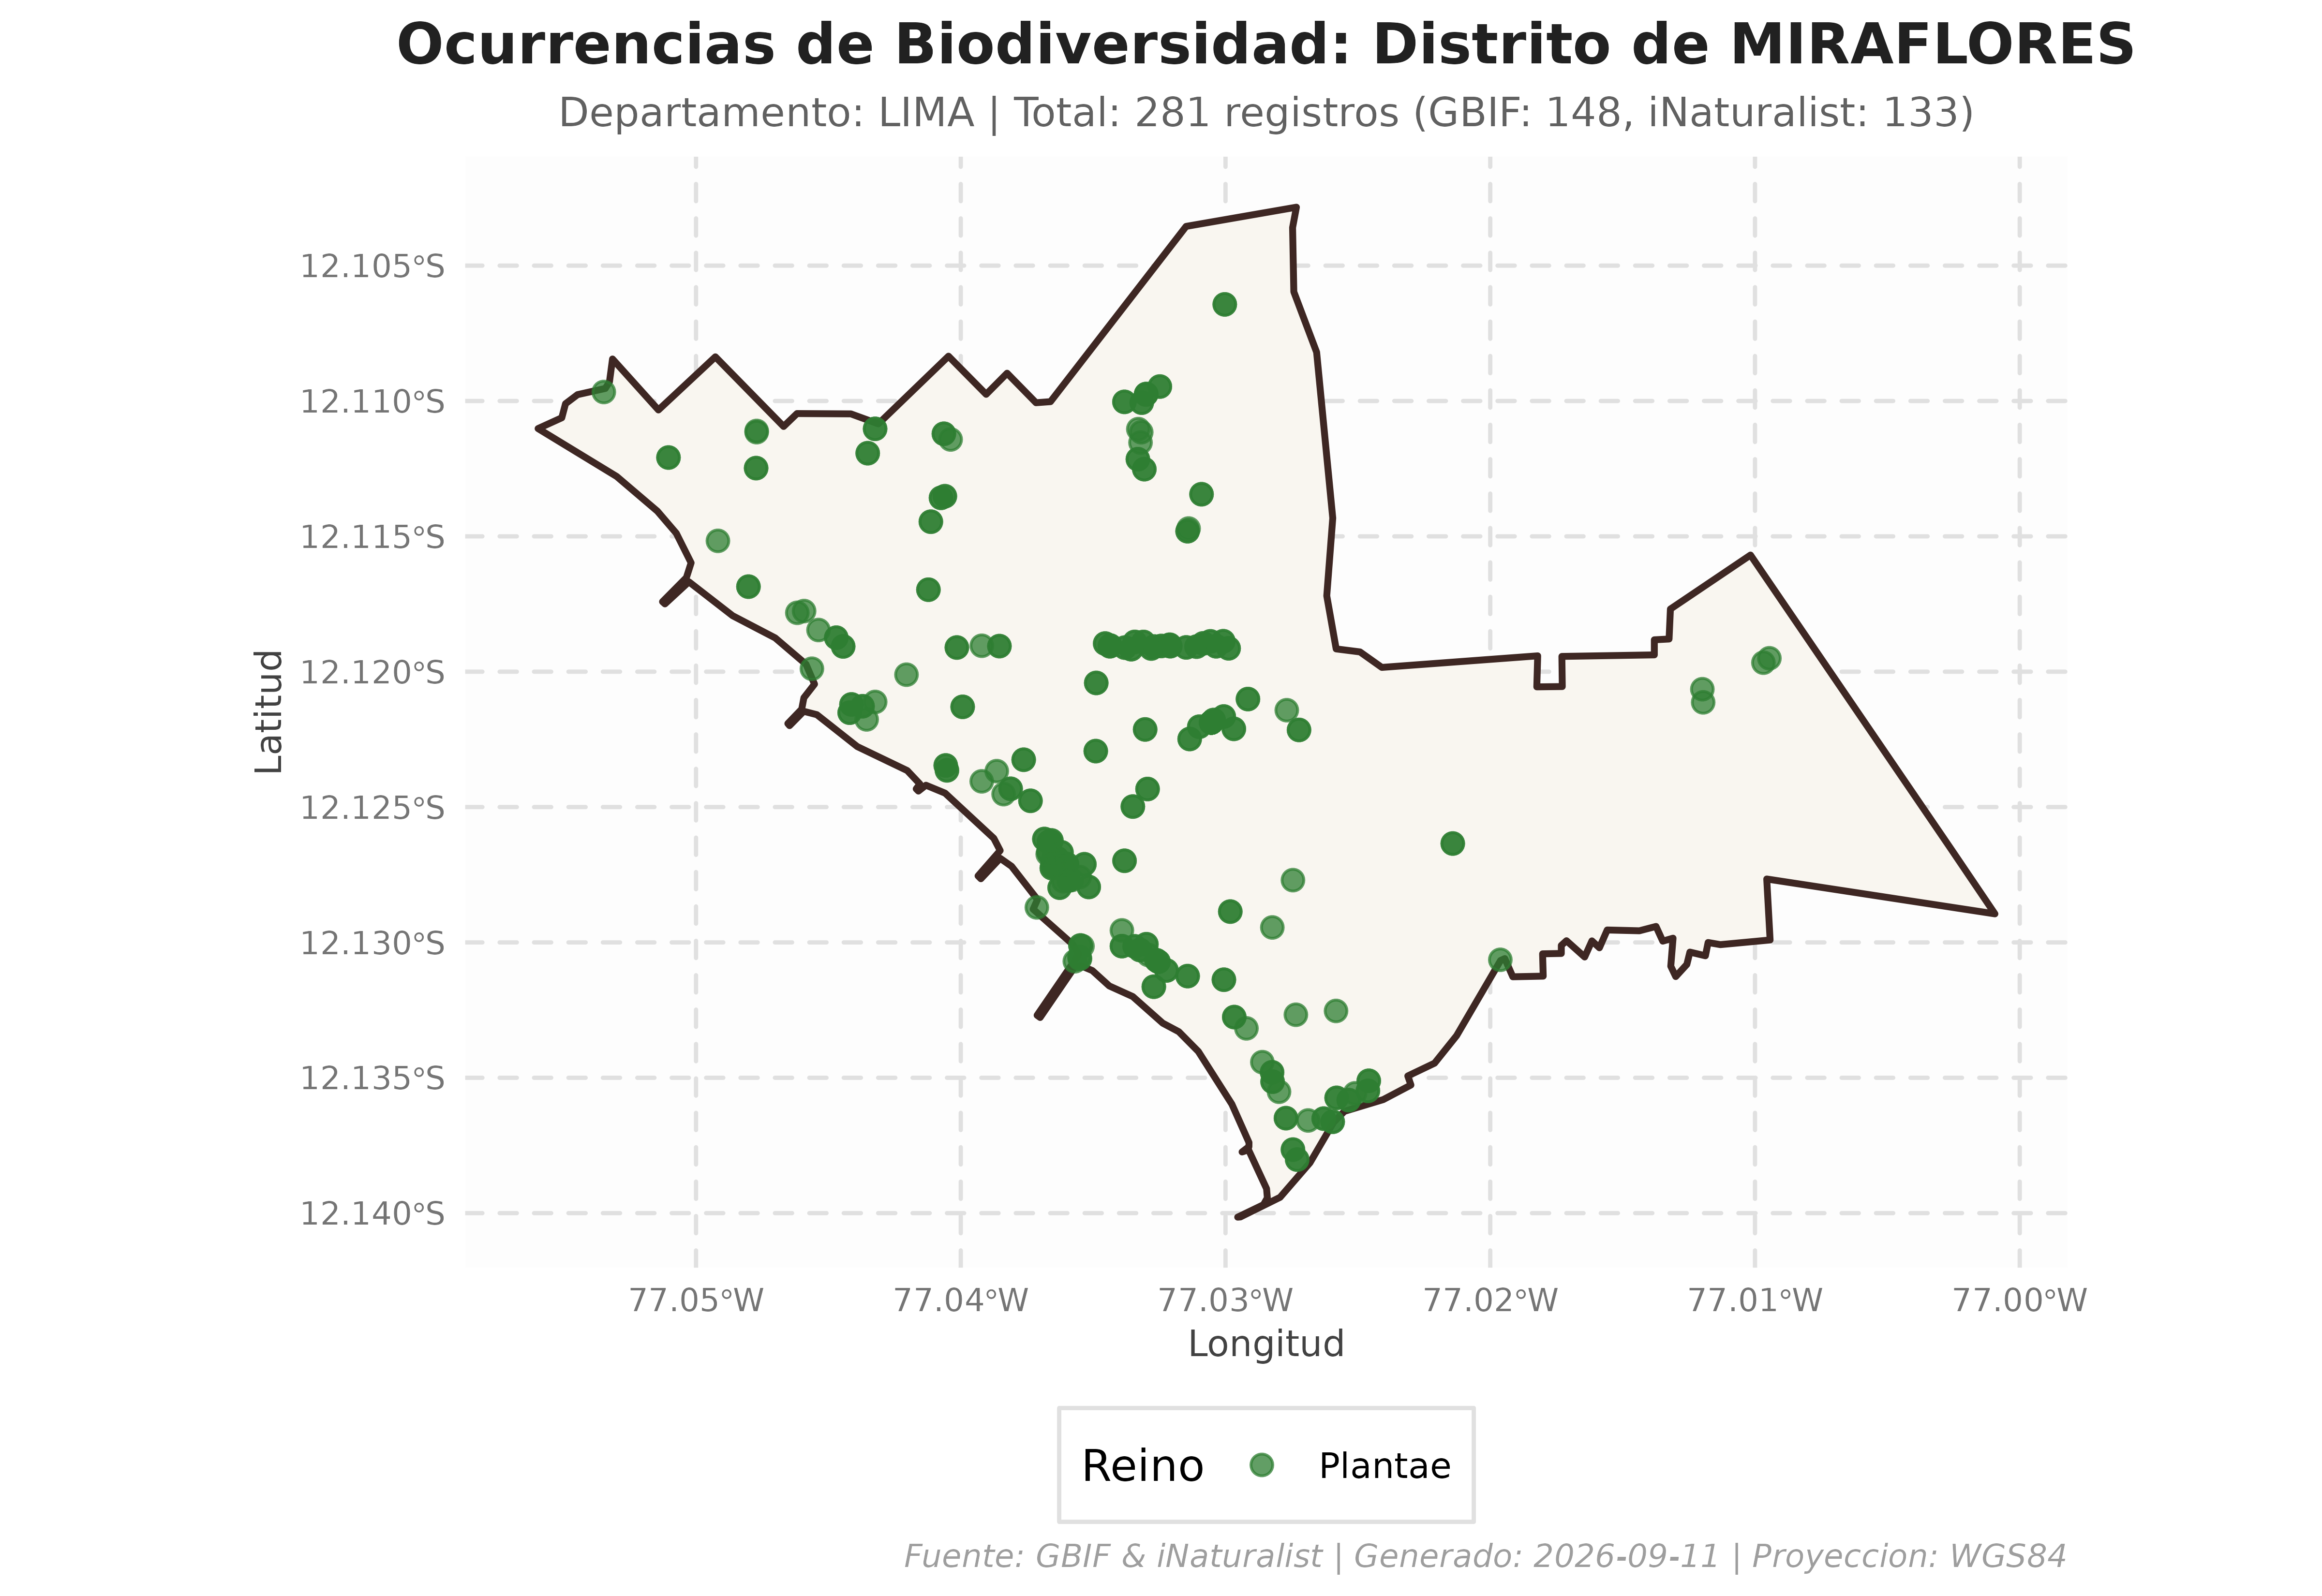
Personalización con Capas de ggplot2
Dado que graficar_ocurrencias() retorna un objeto
estándar de clase ggplot, puedes extenderlo y
personalizarlo con cualquier tema, escala o etiqueta de
ggplot2:
library(ggplot2)

mapa_personalizado <- mapa_fuente +
  ggplot2::theme_minimal(base_size = 12) +
  ggplot2::labs(
    title = "Biodiversidad en Miraflores, Lima",
    subtitle = "Ocurrencias consolidadas vía peruocc (GBIF + iNaturalist)",
    caption = "Fuente: Repositorios de Biodiversidad / INEI geoperu"
  )

print(mapa_personalizado)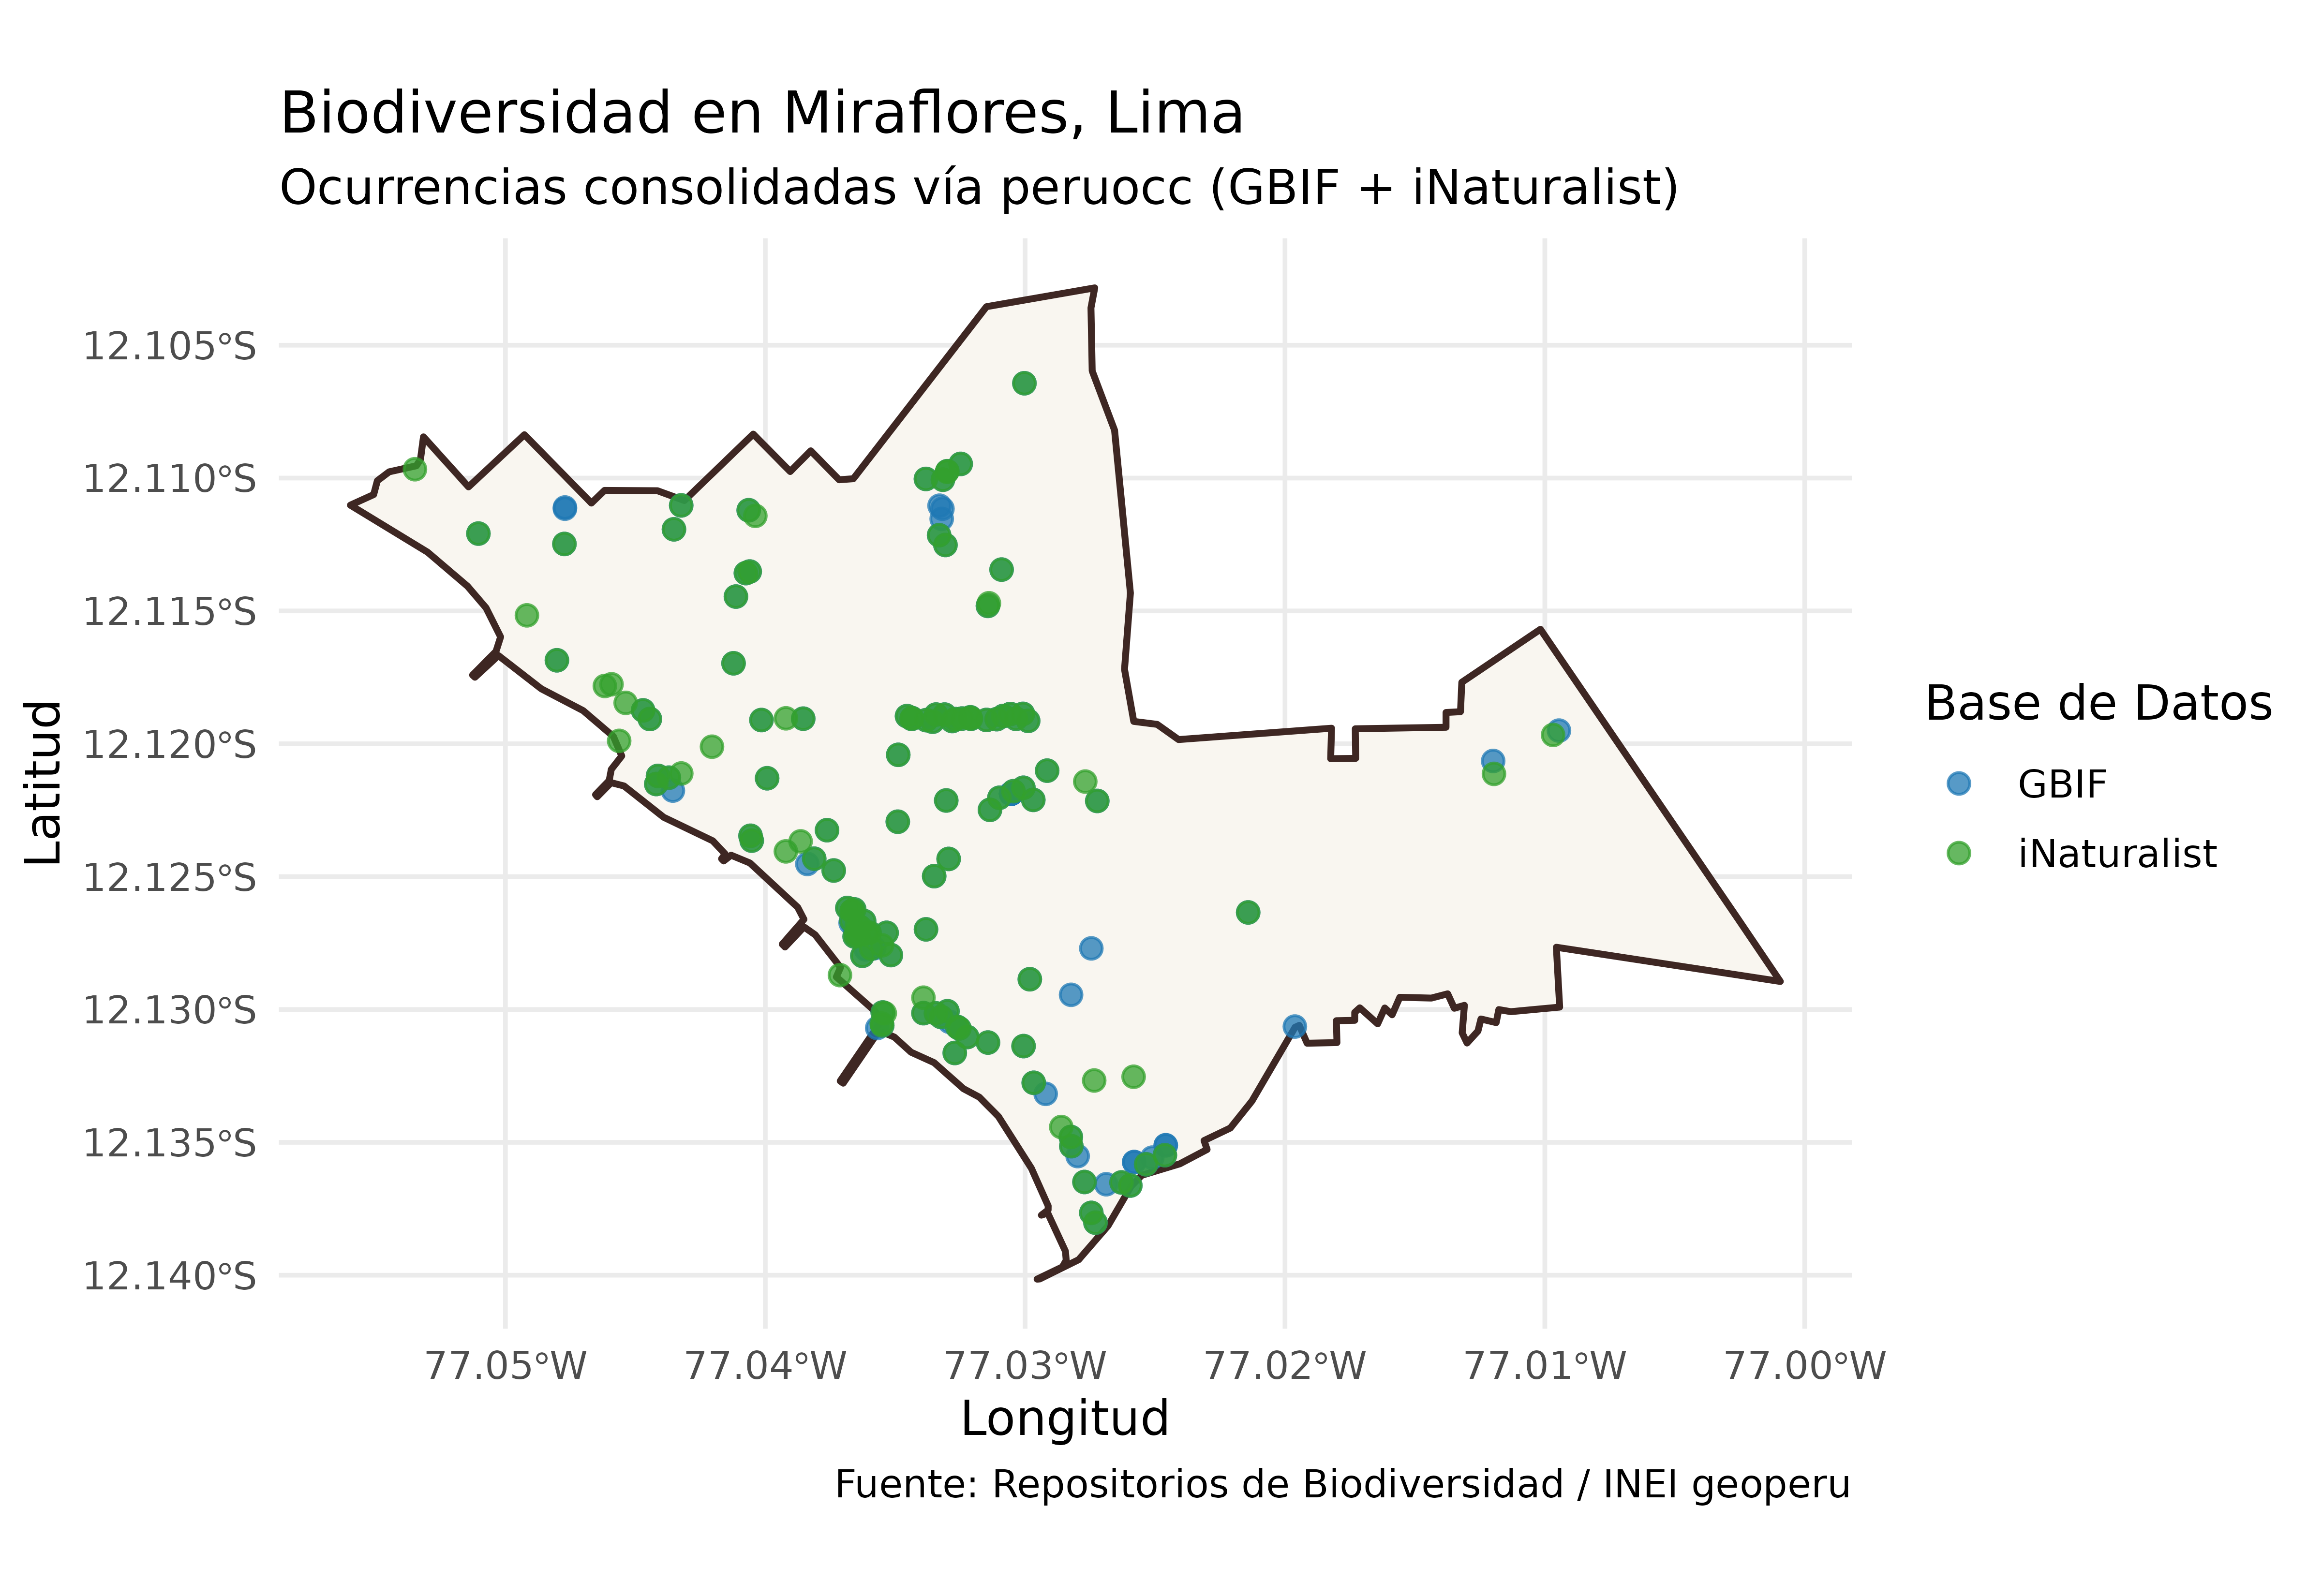
Exportar el Mapa Directamente a Imagen
# Genera y guarda automáticamente el mapa en results/ en formato PNG a 300 DPI
mapa_guardado <- graficar_ocurrencias(
  resultado_lista = resultado,
  color_por = "source",
  guardar_mapa = TRUE
)
5. Auditoría Científica: Estructura del Manifiesto JSON
El archivo manifiesto_*.json almacena metadatos críticos
para publicaciones científicas y auditorías reproducibles:
{
  "timestamp_utc": "2026-08-29T15:00:00Z",
  "paquetes": {
    "peruocc": "0.1.0",
    "sf": "1.0-19",
    "rgbif": "3.8.5",
    "rinat": "0.1.10"
  },
  "parametros": {
    "unidad": "Miraflores",
    "nivel": "distrito",
    "departamento": "Lima",
    "grupo": "flora",
    "limite_por_api": 150
  },
  "archivos_generados": [
    "ocurrencias_distrito_miraflores_flora.csv",
    "ocurrencias_distrito_miraflores_flora.geojson"
  ]
}